Escalabilidade limitada em bancos SaaS multi-tenant quase nunca nasce do volume total de dados. O gargalo costuma aparecer quando a arquitetura mistura tenants com perfis muito diferentes, sem isolamento suficiente, sem política de conexões e sem observabilidade por cliente. Para times de produto, engenharia e plataforma, a saída é tratar o banco como uma camada de isolamento progressivo, não como um repositório único que cresce de forma linear.
Na prática, isso significa combinar modelo de tenancy adequado, particionamento desde cedo, proteção contra noisy neighbor e operação disciplinada. É exatamente esse tipo de desenho que a Interserv Cloud ajuda empresas críticas a estruturar em AWS, com foco em resiliência, segurança e previsibilidade operacional.
Principais pontos para destravar escala
- Escolha o isolamento pelo perfil dos tenants, não apenas pelo menor custo inicial.
- Evite concentração de carga com particionamento e critérios claros para mover contas grandes.
- Proteja o banco de explosão de conexões com pooling e limites transacionais.
- Monitore por tenant, porque média global esconde gargalos reais.
- Planeje um modelo híbrido, para manter pequenos clientes em pool e isolar contas sensíveis ou muito pesadas.
- Teste distribuição e crescimento antes da próxima onda comercial, não depois do incidente.
O erro mais comum é usar um único modelo para todos os clientes
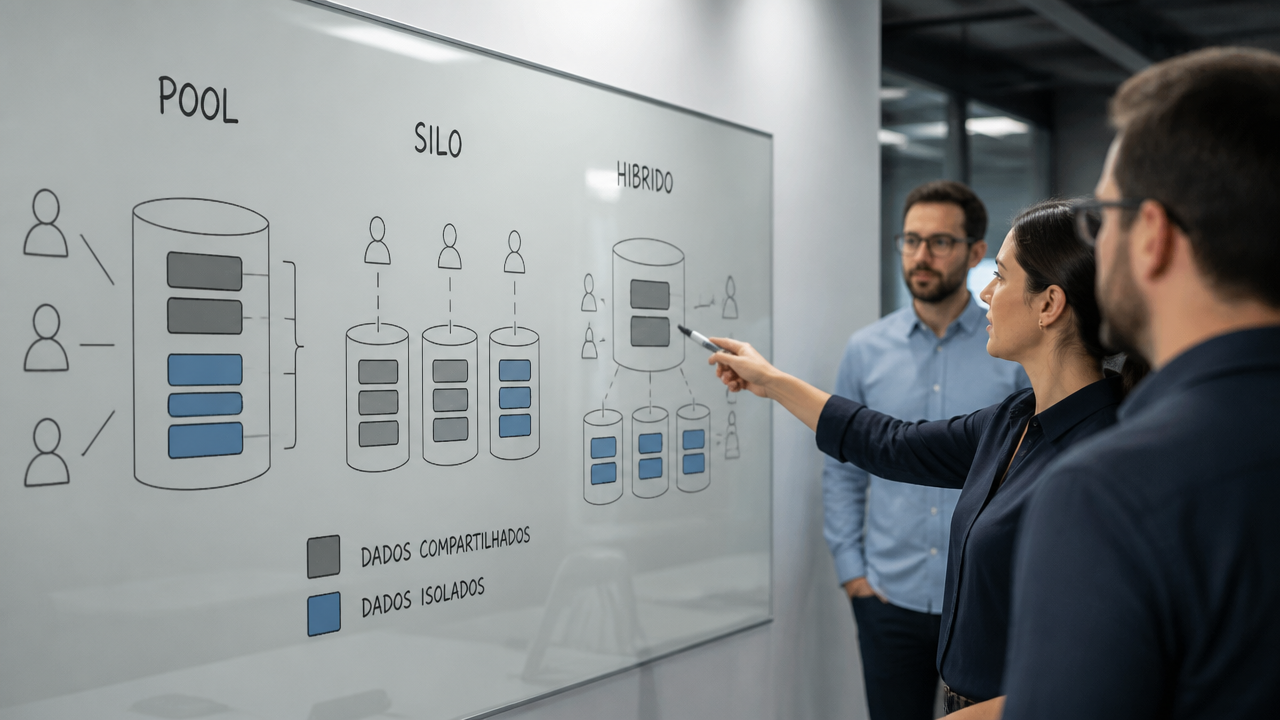
O maior risco não é optar por pool, silo ou híbrido. O erro está em insistir no mesmo modelo para toda a base, mesmo quando os tenants já têm comportamentos opostos. A própria AWS destaca que ambientes compartilhados aumentam a chance de noisy neighbor, ampliam o escopo de impacto de falhas e dificultam atribuição de consumo por tenant.
Por isso, a pergunta correta não é “qual modelo é melhor?”, mas “qual nível de isolamento cada faixa de cliente exige?”. Em SaaS B2B, é comum que a maior parte da base funcione bem em ambiente compartilhado, enquanto poucos clientes exigem banco dedicado, leitura separada, limites mais rígidos ou até rota própria de processamento. A AWS e a Microsoft tratam esse desenho como isolamento direcionado, ou modelo híbrido, justamente para equilibrar escala, custo e proteção operacional.
Qual modelo de banco reduz o risco de gargalo?
Para a maioria dos SaaS em crescimento, o melhor caminho inicial é um modelo compartilhado com regras duras de isolamento lógico e trilha clara para promover tenants críticos a uma camada mais isolada. Esse arranjo evita complexidade prematura, mas não prende a plataforma a um único banco ou cluster.
Uma forma simples de comparar:
| Modelo | Vantagem principal | Risco de escala | Quando usar |
|---|---|---|---|
| Pool | Melhor eficiência de custo | Noisy neighbor e maior raio de impacto | Base ampla de clientes pequenos e médios |
| Silo | Isolamento forte | Mais operação, mais custo e mais conexões totais | Clientes regulados ou com carga muito alta |
| Híbrido | Equilíbrio entre escala e isolamento | Governança mais complexa | SaaS com perfis de tenants heterogêneos |
O ponto decisivo é prever mobilidade. Se sua arquitetura não permite mover um tenant do pool para um ambiente mais isolado sem trauma, o teto de escala já está embutido no desenho inicial.
Sharding deve entrar antes da crise, não depois
Sharding não é um remédio para banco já colapsado. Ele é um mecanismo de distribuição que precisa nascer com critérios claros, como região, faixa de tenants, volume de escrita ou tamanho da conta. A SaaS Lens recomenda validar políticas de distribuição de dados com testes específicos, justamente para confirmar que o crescimento real dos tenants será espalhado de forma saudável.
Na prática, vale definir desde cedo:
- qual é a chave de distribuição principal;
- quais métricas disparam rebalancing;
- como promover um tenant grande para shard dedicado;
- como manter roteamento, migração e observabilidade consistentes.
Sem isso, o sistema até cresce, mas concentra escrita, índices quentes e filas de manutenção em poucos nós. O resultado é latência irregular e incidentes difíceis de reproduzir. Em ambientes críticos, a Interserv Cloud costuma tratar esse ponto junto com capacidade, failover e segurança, porque shard mal definido vira problema de operação, não só de modelagem.
Conexões demais podem derrubar um banco saudável
Muitos bancos multi-tenant falham antes mesmo de saturar CPU ou armazenamento. Eles travam por explosão de conexões simultâneas, especialmente quando há APIs, workers e funções serverless abrindo sessões curtas o tempo todo. A documentação do Amazon RDS Proxy afirma que o serviço faz connection pooling, reutiliza conexões, reduz overhead de CPU e memória no banco e ajuda a absorver picos imprevisíveis de tráfego.
Além disso, o RDS Proxy pode enfileirar, limitar ou rejeitar excesso de conexões para preservar previsibilidade, em vez de deixar o banco falhar de forma abrupta. A AWS também documenta que o tamanho do pool é governado por parâmetros relativos ao limite de conexões do banco, como MaxConnectionsPercent.
Para times de engenharia, a lição é objetiva:
- use pooling de conexão sempre que o perfil de acesso for volátil;
- encurte transações e evite sessões presas;
- separe tráfego transacional de rotinas pesadas;
- estabeleça limites por serviço e por tenant quando possível.
Como evitar o efeito noisy neighbor?
Você evita noisy neighbor quando mede consumo por tenant e aplica contenção antes que um cliente afete os demais. A AWS trata esse problema como um risco natural do modelo compartilhado e recomenda identificar gargalos potenciais e isolar recursos de tenants de alta demanda quando necessário.
Na operação, isso costuma envolver quatro controles combinados:
- quotas de throughput, jobs e concorrência por tenant;
- filas separadas para tarefas pesadas;
- réplicas ou bancos dedicados para contas muito exigentes;
- alertas baseados em percentil por tenant, não só em média global.
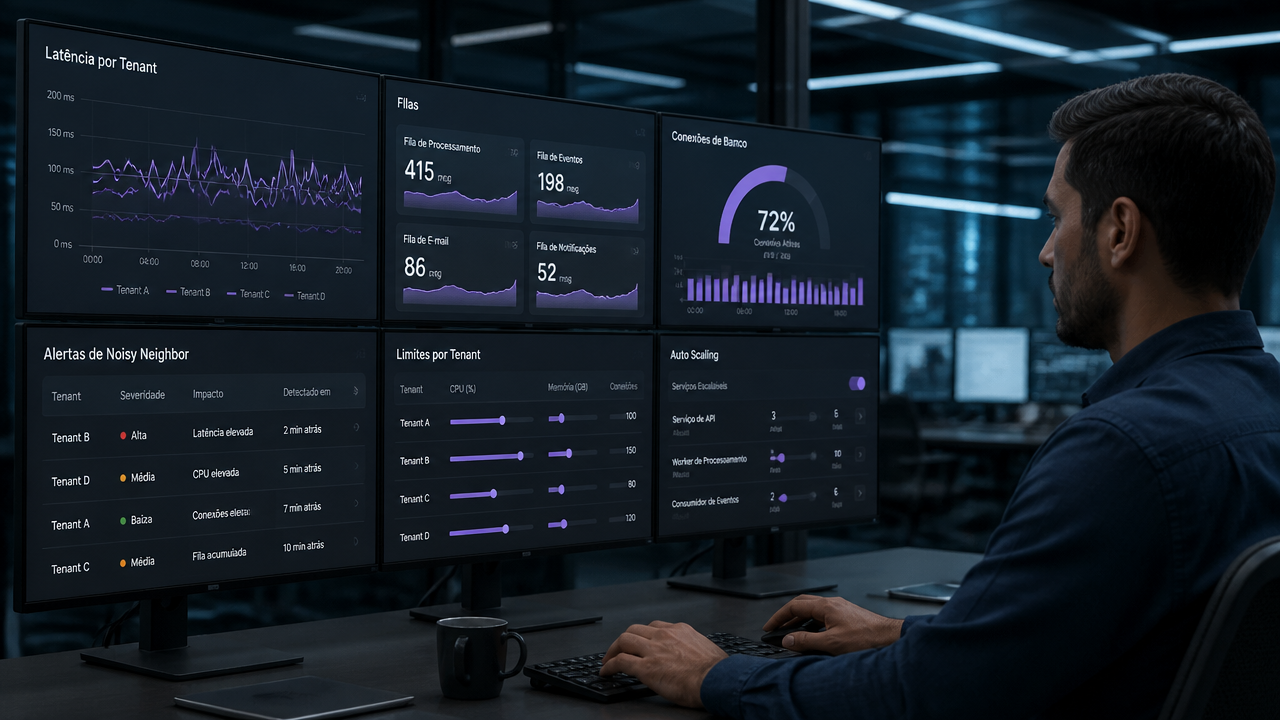
Esse último ponto é decisivo. Quando você olha apenas CPU média do cluster, parece que tudo está bem. Quando olha latência P95 por tenant, enxerga quem está degradando a experiência do restante da base.
Observabilidade por tenant é o que transforma escala em rotina
Escala sustentável depende menos de heroísmo em incidentes e mais de visibilidade granular. Se você não mede latência, erros, conexões, filas e consumo por tenant, não consegue decidir quem deve continuar no pool, quem precisa de isolamento adicional e qual shard está ficando desequilibrado.
Uma operação madura monitora, no mínimo:
- latência P95 e P99 por rota e por tenant;
- quantidade de conexões abertas, emprestadas e em espera;
- consultas lentas por padrão de uso;
- crescimento de dados e índices por cliente;
- tempo de execução de jobs assíncronos;
- eventos de failover e recuperação.
Esse é o ponto em que monitoramento, segurança e escalabilidade deixam de ser áreas separadas. Em ambientes que não podem parar, o desenho do banco precisa conversar com resposta a incidentes, trilhas de auditoria e proteção de credenciais desde o início.
Qual é a arquitetura mais segura para crescer sem refazer tudo?
A arquitetura mais segura, no sentido técnico e operacional, costuma ser híbrida: banco compartilhado para a maioria dos tenants, critérios claros de promoção para isolamento adicional e automação para mover contas sem reescrever a aplicação. Isso reduz custo no começo e preserva margem de evolução quando surgem clientes maiores, auditorias mais duras ou picos sazonais.
Se o seu SaaS já sofre com lentidão intermitente, filas de conexão ou clientes que puxam o ambiente inteiro para baixo, o problema provavelmente não é “falta de banco”. É falta de estratégia de isolamento, distribuição e observabilidade. Resolver isso cedo custa menos do que sustentar incidentes recorrentes. E é justamente nessa transição, da arquitetura que cresce por improviso para a arquitetura que cresce com previsibilidade, que a Interserv Cloud pode apoiar times que operam workloads críticos em AWS.
Perguntas frequentes
O que é um SaaS multi-tenant?
Multi-tenant é um modelo em que vários clientes compartilham a mesma aplicação e, em muitos casos, a mesma camada de dados, com isolamento lógico por tenant. Ele reduz custo operacional, mas exige controles melhores de isolamento, observabilidade e contenção para evitar gargalos e impacto cruzado.
Qual a diferença entre multi-tenancy e multi-tenant?
Multi-tenancy é o conceito arquitetural. Multi-tenant costuma descrever a aplicação ou plataforma que implementa esse conceito. Na prática, os termos aparecem como sinônimos no mercado, mas o ponto importante é como o isolamento entre clientes é desenhado e operado.
Banco compartilhado sempre limita a escalabilidade?
Nem sempre. Um banco compartilhado funciona bem quando há governança de consultas, limites por tenant, connection pooling, particionamento e observabilidade. Quando esses controles faltam, o ambiente sofre com noisy neighbor, contenção de conexões e dificuldade para crescer com previsibilidade.
Quando vale adotar sharding em um SaaS multi-tenant?
Sharding passa a fazer sentido quando um único banco ou cluster começa a concentrar tenants com perfis muito diferentes, alto volume de escrita ou crescimento desigual. O ideal é introduzir critérios de particionamento antes da dor virar incidente, e validar a distribuição com testes de carga por tenant.
O que é noisy neighbor em arquitetura multi-tenant?
O problema aparece quando a carga de um cliente piora a experiência dos demais em um ambiente compartilhado. Em bancos SaaS, isso costuma acontecer por consultas pesadas, picos de conexão, transações longas, jobs concorrentes ou distribuição ruim de dados e recursos.