Padronizar metadados na AWS com apoio de IA é um caminho prático para reduzir ambiguidade, acelerar descoberta de dados e evitar que cada squad invente seu próprio dicionário. Isso faz mais diferença em ambientes com muitos domínios, múltiplos lagos de dados e integrações frequentes. Para times de dados, segurança e plataforma, o ganho real aparece quando o catálogo deixa de ser só inventário e vira uma camada confiável de contexto para analytics, automação e aplicações com LLMs.
O ponto central é simples: LLM não deve decidir sozinho o que é verdade. Ele funciona melhor como acelerador de classificação, sugestão semântica e enriquecimento de descrições, enquanto o controle final permanece em regras, versionamento e governança.
Destaques práticos do guia
- Catálogo sem política não resolve: centralizar metadados é o primeiro passo, não o último.
- LLMs são ótimos para sugerir equivalências, mas precisam de validação para campos críticos.
- Uma arquitetura simples vence a complexa: ingestão, normalização, revisão e publicação já cobrem grande parte dos casos.
- Segurança precisa entrar no prompt design, com mascaramento, contexto mínimo e trilha de auditoria.
- FinOps importa desde o piloto, porque inferência mal desenhada encarece rápido.
Harmonizar metadados não é renomear colunas, é alinhar significado
A conclusão mais importante é esta: o problema não está só em nomes diferentes, mas em conceitos diferentes escondidos sob nomes parecidos. Quando marketing, risco e operações usam a palavra “cliente” com critérios distintos, o catálogo técnico fica organizado, mas a decisão de negócio continua inconsistente.
Por isso, a harmonização precisa juntar três camadas: estrutura técnica, semântica de negócio e política de uso. Na AWS, isso costuma começar com o AWS Glue Data Catalog para inventário e descoberta. A partir daí, o time define glossários, owners, sensibilidade do dado e regras mínimas para publicação.
Segundo a documentação da AWS, o Glue Data Catalog atua como repositório central de metadados para ativos analíticos, o que o torna uma base natural para padronização. Já os materiais da AWS sobre IA generativa e boas práticas com LLMs reforçam que contexto, avaliação e guardrails precisam ser tratados como componentes do sistema, não como detalhe de implementação.
Qual arquitetura funciona melhor na AWS para esse caso?
Na maioria dos ambientes, a melhor arquitetura é a que separa descoberta, inferência e aprovação. Isso evita que o modelo escreva diretamente no catálogo sem checagem e permite medir qualidade em cada etapa.
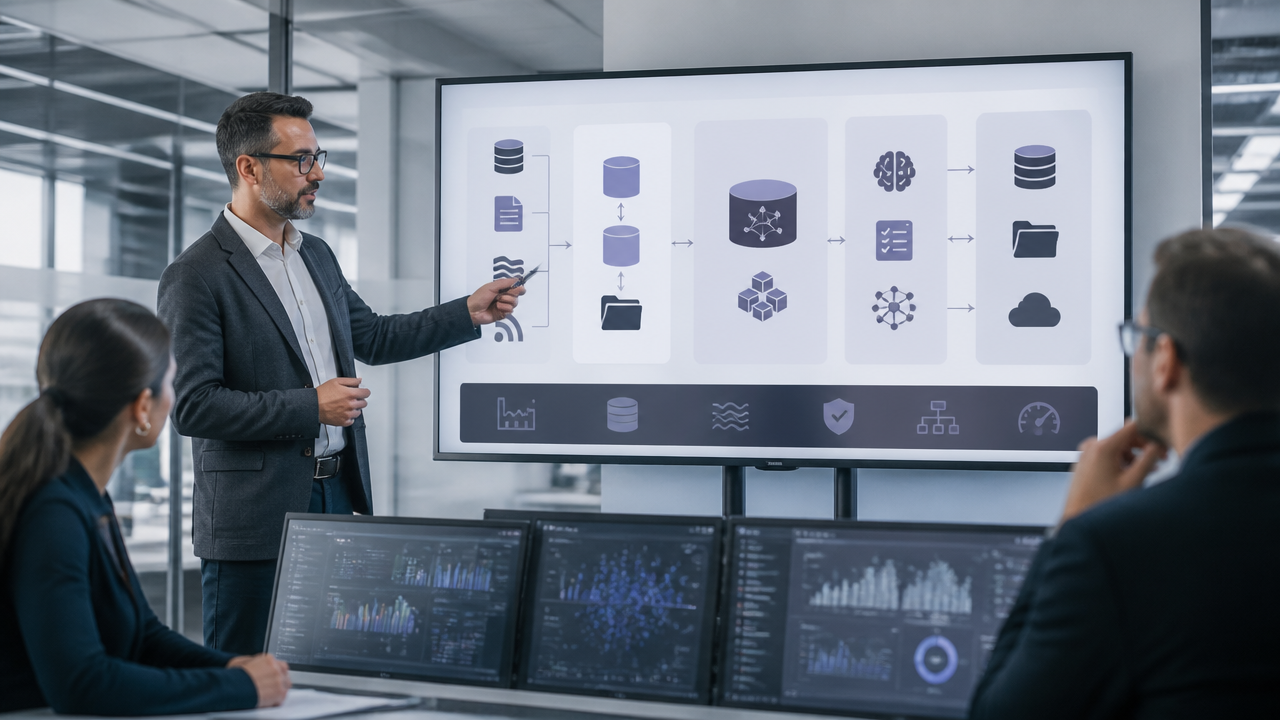
Camada 1, descoberta e coleta
Use crawlers e conectores para levantar esquemas, descrições existentes, tags e lineage básico. O objetivo aqui não é inteligência, e sim cobertura confiável das fontes em S3, RDS, Redshift e demais repositórios suportados.
Camada 2, normalização determinística
Antes do LLM, padronize o que é objetivo: casing, prefixos, tipos, formatos de data, convenções de partição e domínios conhecidos. Essa etapa reduz ruído e melhora muito a qualidade das sugestões semânticas.
Camada 3, enriquecimento com IA
Com Amazon Bedrock, o modelo pode sugerir descrições padronizadas, equivalências entre campos, classificação de domínio e rótulos de sensibilidade. O ideal é enviar apenas o contexto necessário, como nome da coluna, tabela, amostra mascarada e definição de glossário.
Camada 4, aprovação e publicação
As sugestões voltam para revisão humana ou para regras de confiança por score. Só depois disso os metadados harmonizados são promovidos para consumo em catálogo, busca e documentação interna.
Onde IA e LLMs realmente ajudam, e onde atrapalham
LLMs ajudam muito quando o desafio é semântico e distribuído. Eles funcionam bem para detectar que “dt_nasc”, “birth_date” e “data_nascimento” provavelmente representam o mesmo conceito, mesmo quando os times usaram padrões diferentes por anos.
Eles também aceleram a escrita de descrições úteis, resumos para datasets e agrupamentos por domínio de negócio. Em equipes enxutas, isso reduz o backlog de curadoria e melhora a adoção do catálogo, porque o usuário encontra contexto legível em vez de metadado cru.
O problema aparece quando se delega decisão normativa ao modelo. LLM pode confundir conceitos próximos, exagerar confiança ou sugerir taxonomias boas no texto, mas ruins para compliance. Por isso, os melhores resultados surgem quando o modelo propõe e o sistema governa.
| Atividade | LLM é indicado? | Observação |
|---|---|---|
| Sugerir equivalência entre campos | Sim | Exija score de confiança e revisão por amostragem |
| Padronizar tipos e formatos | Não, regra é melhor | Determinismo reduz erro e custo |
| Gerar descrição de dataset | Sim | Use glossário e contexto mínimo |
| Classificar dado sensível | Parcialmente | Combine modelo com políticas fixas |
| Publicar no catálogo final | Não sozinho | Versionamento e auditoria são obrigatórios |
Como montar um piloto que prova valor em poucas semanas
O melhor piloto é restrito, mas mensurável. Escolha um domínio com dor real, como cadastro de clientes, pedidos ou produtos, e estabeleça um conjunto pequeno de fontes com duplicidade de significado já conhecida.
Em seguida, defina um glossário mínimo com 20 a 50 conceitos prioritários. Esse glossário serve como referência para o modelo propor mapeamentos, descrições e tags de negócio. Sem essa base, o LLM tende a produzir respostas fluidas, porém inconsistentes.
Um piloto bem desenhado costuma seguir esta sequência:
- inventariar fontes e owners;
- selecionar conceitos críticos e suas definições aprovadas;
- normalizar padrões técnicos por regra;
- usar LLM para sugerir equivalências e descrições;
- revisar uma amostra com especialistas do domínio;
- publicar só o que atingiu critérios mínimos de qualidade.
Se a sua operação depende de disponibilidade, segurança e governança contínua, a Interserv Cloud pode apoiar esse desenho na AWS, conectando catálogo, observabilidade e controles de produção sem transformar o piloto em um experimento difícil de operar.
Segurança, LGPD e custos precisam entrar no desenho desde o início
Em ambientes regulados, o risco não está apenas no dado final publicado. Ele começa no caminho que o metadado percorre até chegar ao modelo. Se nomes de campos, comentários ou amostras carregam PII, o prompt já pode virar um ponto de exposição.
Por isso, adote algumas proteções desde o primeiro fluxo:
- mascarar ou sintetizar amostras antes da inferência;
- enviar contexto mínimo ao modelo;
- registrar prompt, resposta, score e decisão final;
- separar ambientes de teste e produção;
- monitorar custo por lote, domínio e volume processado.
Os materiais da AWS sobre workloads de IA generativa deixam claro que otimização de inferência e governança operacional são fatores de produção, não apenas de laboratório. Em outras palavras, o projeto dá certo quando segurança, observabilidade e FinOps são tratados como partes do produto.
Quais métricas mostram que a harmonização está funcionando?
Sem métrica, o catálogo parece melhor, mas ninguém sabe se ficou mais útil. O conjunto mínimo deve medir qualidade semântica, adoção e eficiência operacional.
As métricas mais práticas são:
- taxa de campos harmonizados com aprovação humana;
- precisão das sugestões do LLM por domínio;
- tempo médio para curadoria de novo dataset;
- redução de termos duplicados no glossário;
- percentual de ativos com owner, classificação e descrição completa;
- custo por mil atributos processados.
Se esses indicadores sobem juntos, há sinal de maturidade real. Se a cobertura cresce, mas a revisão humana rejeita grande parte das sugestões, o problema costuma estar no prompt, no glossário ou na falta de regras determinísticas antes da etapa semântica.
Perguntas frequentes
O que é harmonização de metadados e por que ela importa?
É o processo de unificar nomes, descrições, classificações e regras de uso de dados vindos de sistemas diferentes. Na prática, ele reduz ambiguidades como cliente_id, id_cliente e customer_id, criando um vocabulário consistente para analytics, governança e aplicações com IA.
LLMs substituem regras de catálogo e governança?
Não. Regras determinísticas continuam essenciais para campos críticos, domínios regulados e políticas de segurança. LLMs ajudam a interpretar contexto, sugerir mapeamentos e acelerar classificação, mas a publicação deve passar por validação, versionamento e trilha de auditoria.
Quais serviços da AWS fazem mais sentido nesse cenário?
Glue Data Catalog, AWS Glue Crawlers, Lake Formation e Amazon Bedrock costumam formar a base mais prática. Em cenários maiores, vale incluir Athena para consultas, Step Functions para orquestração e CloudWatch para monitoramento operacional.
Quais riscos de segurança existem ao usar IA nesse processo?
Os riscos principais são vazamento de dados sensíveis no prompt, classificação incorreta, custos de inferência mal controlados e decisões sem auditoria. A mitigação passa por minimização de contexto, mascaramento, aprovação humana em casos críticos e métricas contínuas de precisão.
Como começar um projeto piloto sem elevar a complexidade?
Comece com um domínio pequeno e mensurável, como cadastro de clientes ou catálogo de produtos. Defina um glossário mínimo, escolha fontes prioritárias, crie regras de validação e use o LLM apenas para sugerir equivalências e descrições antes de escalar para outras áreas.