Se a meta é colocar um RAG com comportamento mais autônomo em produção na AWS, a combinação entre Amazon Bedrock Managed Knowledge Base e Amazon Bedrock AgentCore é hoje um dos caminhos mais curtos para sair do protótipo e chegar a uma arquitetura operável. Ela faz mais sentido para times que precisam responder sobre conteúdo corporativo com rastreabilidade, sem assumir a operação de vector database, pipelines de ingestão e cola de integração entre ferramentas. Segundo a documentação e os anúncios da AWS em 2026, a proposta é justamente mover para serviços gerenciados a parte mais trabalhosa do stack de retrieval e execução de agentes.
Na prática, isso interessa a times de plataforma, engenharia de dados e segurança que precisam de respostas melhores, menor tempo de implantação e menos superfícies para falha. O ponto central deste guia é simples: use a Managed Knowledge Base para cuidar do ciclo de ingestão e recuperação, e use o AgentCore para expor ferramentas, manter sessões e executar o agente com disciplina operacional.
Destaques que realmente mudam o desenho da solução
- Managed Knowledge Base reduz infraestrutura operacional: a AWS gerencia ingestão, storage, indexação, embeddings e otimizações de retrieval por padrão.
- Agentic retrieval atende perguntas multi-hop: planejamento, iteração e avaliação de suficiência podem ocorrer dentro do serviço, em vez de no código da aplicação.
- AgentCore organiza a execução do agente: Runtime, sessões e Gateway ajudam a transformar PoC em workload operável.
- Há limites que afetam escala desde o início: por padrão, a Managed Knowledge Base suporta até 600 chamadas Retrieve por minuto por base e 300 chamadas AgenticRetrieveStream por minuto por conta.
- Segurança começa na modelagem da fonte: permissões IAM, service role e controle de acesso por documento precisam ser definidos antes do primeiro sync.
Cada serviço deve resolver um problema diferente
A melhor arquitetura é a que separa responsabilidade. A Managed Knowledge Base deve cuidar do conteúdo e da recuperação. O AgentCore deve cuidar do comportamento do agente, do ciclo de execução e da interface com ferramentas. Misturar essas camadas cedo demais costuma produzir um agente difícil de testar, mais caro de operar e com observabilidade confusa.
Na visão atual da AWS, a Managed Knowledge Base já nasce com conectores para fontes como Amazon S3, SharePoint, Confluence, Google Drive, OneDrive e Web Crawler, além de integração nativa com AgentCore Gateway. A mesma documentação destaca suporte a ACL em nível de documento, exceto no conector Web Crawler, o que é relevante para ambientes com perfis distintos de acesso.
Quando essa abordagem vale mais do que um RAG tradicional
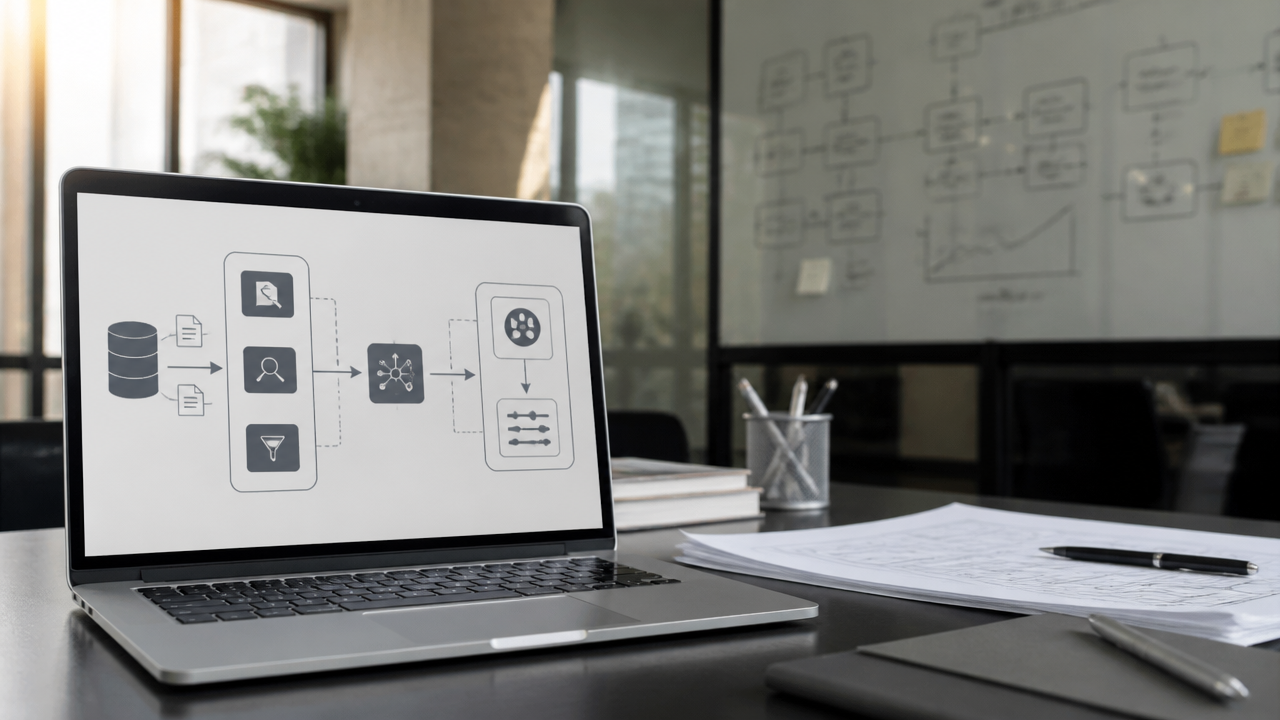
Ela vale mais quando a pergunta do usuário não se resolve com um único top-k de trechos. Consultas corporativas reais costumam exigir decomposição, busca em fontes diferentes, reavaliação do que já foi encontrado e nova rodada de recuperação. É exatamente aí que o agentic retrieval ganha espaço, porque transfere esse ciclo para o serviço gerenciado.
Já um RAG tradicional ainda pode ser suficiente em FAQs simples, catálogos pequenos ou fluxos em que a pergunta sempre aponta para um documento previsível. Se o seu caso depende de múltiplos documentos, regras dispersas, tabelas e histórico operacional, o ganho da abordagem agentic aparece rápido em qualidade e redução de código de orquestração. O próprio material técnico da AWS passou a recomendar a Managed Knowledge Base como combinação otimizada entre facilidade, acurácia e custo operacional.
Arquitetura mínima recomendada para começar sem retrabalho
O desenho inicial deve ser pequeno, mas completo o bastante para não virar débito técnico. Em vez de sair conectando várias tools e múltiplas bases, comece com uma base bem curada, uma política de acesso clara e um agente com escopo estreito.
- Fonte de dados: organize documentos em S3 ou em um conector corporativo compatível, com metadata útil para filtro.
- Managed Knowledge Base: configure ingestão, parsing e recuperação com o mínimo de customização possível no início.
- AgentCore Gateway: exponha a base como tool para um agente compatível com MCP, evitando integrações ad hoc.
- AgentCore Runtime: execute o agente em ambiente isolado, com sessão e lifecycle explícitos.
- Observabilidade: registre latência, taxa de erro, traces de retrieval e qualidade da resposta desde o primeiro deploy. A AWS já publicou exemplos recentes com observabilidade em múltiplas camadas para esse padrão.
| Decisão | Começo recomendado | Quando sofisticar |
|---|---|---|
| Número de bases | 1 base por domínio crítico | Quando houver políticas ou taxonomias muito diferentes |
| Estratégia de retrieval | Managed com padrão do serviço | Quando métricas mostrarem lacunas reais |
| Tools no agente | Knowledge Base e 1 ação externa | Quando o fluxo exigir execução transacional |
| Sessão | Curta e isolada por usuário | Quando houver workflow multi-etapas |
Como funciona o fluxo em produção, do documento à resposta
Em produção, o fluxo saudável começa antes da pergunta. Os documentos entram pela fonte conectada, passam por ingestão e indexação, e só então viram contexto recuperável. Quando o usuário consulta o agente, a aplicação não deveria decidir manualmente cada busca se o serviço já consegue fazer isso melhor no modo gerenciado.
O ponto mais importante é que a Runtime e as sessões do AgentCore permitem manter contexto isolado por usuário. Na configuração baseada em microVMs, a documentação informa valores de lifecycle de até 28.800 segundos, ou 8 horas, para sessão ociosa e lifetime máximo. Isso ajuda em jornadas longas, mas exige disciplina para não transformar sessão em memória infinita.
O agentic retrieval resolve tudo sozinho?
Não. Ele reduz a orquestração manual, mas não corrige fonte ruim, documento duplicado ou permissões mal definidas. A qualidade continua dependendo de chunking coerente, taxonomia útil, metadata aproveitável e políticas de acesso alinhadas ao negócio. Em outras palavras, o serviço gerenciado simplifica a mecânica, não substitui governança de conteúdo.
Segurança, custo e operação devem entrar no desenho antes do primeiro teste
O maior erro em RAG corporativo é tratar segurança como etapa final. No Bedrock Managed Knowledge Base, pré-requisitos como IAM role, permissões para acesso à fonte e passagem de role ao serviço já aparecem na configuração inicial. Quando o ambiente exige segregação por cliente, área ou sensibilidade do dado, isso precisa existir no modelo documental e na autorização, não apenas no prompt.
Também vale olhar quotas cedo. A AWS publica, por padrão, até 10.000 managed knowledge bases por conta e região, até 200 data sources por base, até 50 ingestões concorrentes por base, 10 TB de raw data por base e 600 chamadas Retrieve por minuto por knowledge base, com burst de 25 RPS. Para agentic retrieval em streaming, o padrão é 300 requisições por minuto por conta. Esses números ajudam a decidir sharding, domínios de conteúdo e testes de carga.
Erros comuns que atrasam o projeto
- Começar pelo prompt e não pela fonte: se o conteúdo está desorganizado, a resposta continuará inconsistente.
- Expor tools demais logo no início: isso aumenta superfície de erro, custo e dificuldade de avaliação.
- Ignorar métricas de retrieval: sem medir groundedness, suficiência e latência, toda discussão vira opinião.
- Usar sessão longa sem política clara: contexto persistente sem objetivo definido costuma degradar previsibilidade.
- Subestimar autorização por documento: em ambientes regulados, esse ponto pode inviabilizar a solução depois de pronta.
Onde a Interserv Cloud agrega mais valor
O stack da AWS encurta bastante o caminho, mas não elimina decisões críticas de arquitetura. É aqui que uma operação orientada a segurança, resiliência e escala faz diferença. Para empresas que não podem parar, como bancos, telecoms, e-commerces e plataformas de alto tráfego, o desafio não é só responder perguntas com IA. É responder com dado controlado, custo previsível e comportamento auditável.
A Interserv Cloud pode acelerar esse desenho ajudando a definir a fronteira entre dado, retrieval e execução de agente, além de endurecer IAM, observabilidade e operação contínua. Em projetos assim, o ganho real vem menos do hype e mais da capacidade de colocar um agente útil em produção sem abrir mão de governança.
Perguntas frequentes
A Knowledge Base da AWS já é uma solução de RAG?
Sim, desde que você conecte uma fonte de dados à Knowledge Base. Em RAG, a base de conhecimento é a camada que ingere documentos, cria representações para busca e devolve trechos relevantes ao modelo. No Amazon Bedrock, a versão gerenciada concentra ingestão, indexação e recuperação em um serviço só.
O que é o Amazon Bedrock AgentCore na prática?
O Amazon Bedrock AgentCore é a camada operacional para agentes em produção. Ele reúne recursos como Runtime, Gateway, sessões e integração com ferramentas, permitindo executar lógica de agente com menos código de infraestrutura e com controles mais previsíveis para segurança, observabilidade e isolamento.
A Managed Knowledge Base substitui um banco vetorial gerenciado pelo time?
Não sempre, mas em muitos casos sim. Se seu objetivo é acelerar um RAG corporativo sem operar pipeline de ingestão, storage vetorial e tuning de retrieval manualmente, a Managed Knowledge Base reduz bastante o trabalho. Já cenários com requisitos muito específicos podem continuar pedindo componentes próprios.
Por que usar agentic retrieval em vez de busca semântica simples?
Porque ele reduz a lógica customizada no lado da aplicação. Em vez de o agente fazer planejamento, novas buscas e checagem de suficiência fora do serviço, a própria Knowledge Base executa esse ciclo para consultas complexas, com uma chamada única e menor acoplamento no código.
O Amazon Bedrock tem custo inicial baixo para provar valor?
Depende da forma de uso e dos serviços associados. O Bedrock tem cobrança por componentes consumidos, e a Managed Knowledge Base também tem limites e quotas próprios por conta, região e volume de consultas. O melhor caminho é estimar ingestão, consultas por minuto e padrão de sessão antes da implantação.