Se você quer investigar falhas no Amazon EKS com menos adivinhação e menos coleta manual, o caminho mais eficiente hoje é combinar o AWS DevOps Agent com o Operator que roda dentro do cluster. Essa arquitetura é útil para times de plataforma, SRE e DevOps que precisam reduzir MTTR sem depender de alguém abrindo kubectl no momento exato do incidente. O ganho real está em preservar o contexto da falha cedo, quando logs, eventos e estado do pod ainda fazem sentido para análise.
Destaques que mudam a investigação de incidentes no EKS
- O Operator não substitui o agente principal, ele atua como gatilho e coletor local de evidências.
- O valor central está em capturar dados voláteis antes de reschedule, restart ou deleção do pod.
- O acesso ao cluster é feito em modo de leitura por meio da EKS API, o que reduz risco operacional quando bem configurado.
- Em clusters com nós EC2, a coleta pode incluir sinais de nó, desde que o Systems Manager esteja habilitado.
- Em ambientes Fargate, a investigação continua útil, mas a visibilidade fica restrita ao nível Kubernetes.
O que esse fluxo resolve melhor do que a investigação manual
A principal vantagem é começar pela análise, não pela caça às evidências. No processo manual, o plantonista costuma alternar entre eventos do namespace, logs do pod, describe, health dos nós e histórico recente do deployment. Quando o incidente é curto, parte desse material já mudou quando alguém começa a olhar.
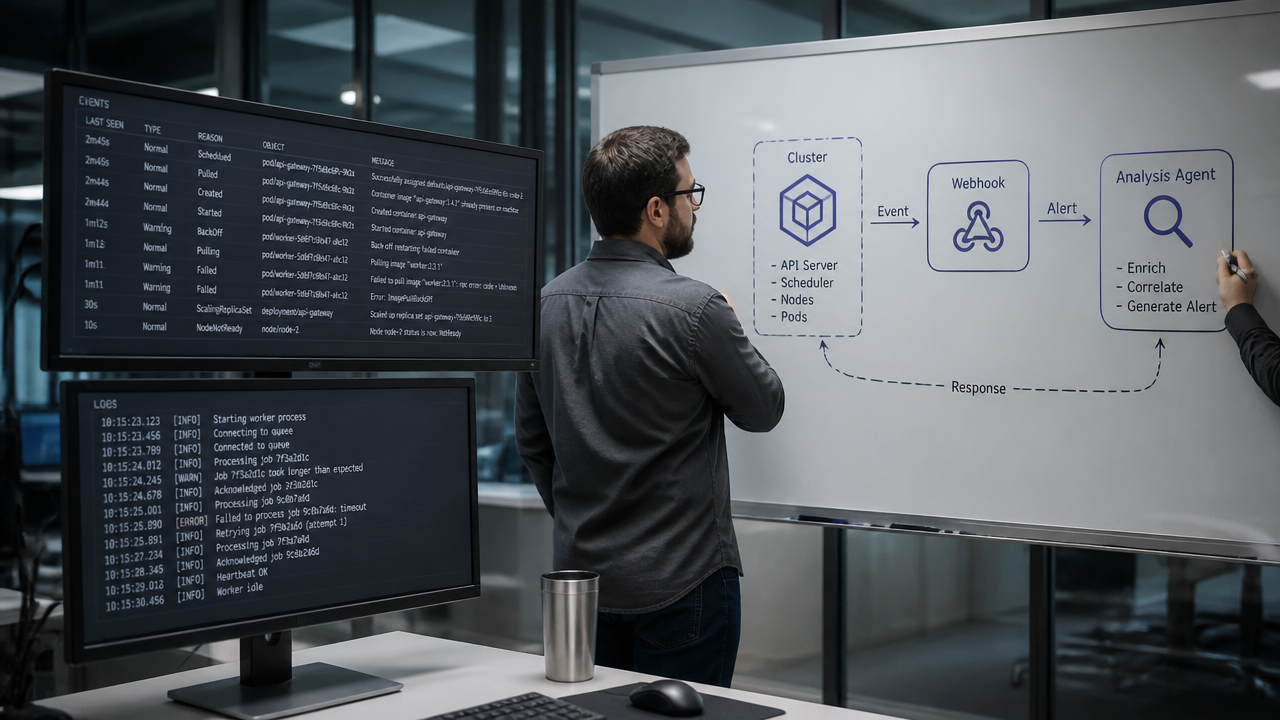
Segundo a documentação da AWS, o AWS DevOps Agent consegue executar comandos de leitura no EKS para descrever recursos, recuperar logs de pods, inspecionar eventos e verificar a saúde dos nós, mas o Operator é o componente que detecta a falha no cluster e aciona a investigação automaticamente por webhook. Em outras palavras, um faz a análise assistida, o outro garante timing e contexto.
Para operações críticas, como as que a Interserv Cloud costuma tratar em ambientes com alta exigência de disponibilidade, essa diferença é prática: menos tempo coletando provas, mais tempo isolando a causa raiz e validando a correção.
Como a arquitetura funciona, na prática
O desenho mais simples tem quatro peças: Agent Space, webhook, Access Entry no EKS e Operator no cluster. Quando um workload falha, o Operator detecta o evento, reúne o contexto e envia um POST para o webhook do agente. A partir daí, a investigação começa com base no material coletado e nas integrações configuradas no Agent Space.
| Componente | Papel na solução | O que observar |
|---|---|---|
| Agent Space | Centraliza integrações, contexto operacional e investigação | Role correta e fontes úteis conectadas |
| Webhook | Recebe o gatilho do Operator | Autenticação e assinatura válidas |
| Access Entry do EKS | Permite acesso de leitura ao cluster | Modo de autenticação com EKS API |
| Operator | Detecta falhas e coleta evidências no cluster | Escopo, namespaces e tipo de worker |
A AWS documenta que webhooks genéricos podem usar HMAC com SHA-256, e o próprio material do serviço descreve os headers e o formato esperado para disparar investigações. Isso é importante porque o Operator depende desse canal para iniciar a análise sem intervenção manual.
Quais permissões e pré-requisitos merecem mais atenção?
O ponto mais sensível é acesso. Para o agente investigar o cluster, a AWS orienta que o modo de autenticação do EKS inclua a EKS API e que você crie uma Access Entry usando o ARN da role do Agent Space. A policy gerenciada indicada na documentação é a AmazonAIOpsAssistantPolicy, com escopo de cluster ou namespaces específicos.
Se o seu EKS roda sobre EC2 e você quer dados em nível de nó, a AWS também recomenda anexar a policy AmazonSSMManagedInstanceCore à role do node group. Sem isso, os nós não aparecem como managed nodes no Systems Manager e a coleta fica limitada ao que existe no plano Kubernetes.
Esse detalhe muda bastante a profundidade do diagnóstico. Em falhas como OOMKilled, CrashLoopBackOff e sintomas ligados a rede ou exaustão de IP, sinais do nó podem encurtar muito a investigação. Já em cenários mais aplicacionais, os eventos do cluster e os logs do container podem ser suficientes.
Passo a passo enxuto para configurar sem ruído
1. Prepare o Agent Space com as integrações que ajudam na análise
Comece conectando as fontes que dão contexto ao incidente, como observabilidade, repositórios e pipeline. O agente foi desenhado para cruzar informações de operações e entrega, então quanto melhor for esse contexto, menos superficial tende a ser a resposta.
2. Crie um webhook genérico seguro
Na prática, o Operator precisa de um endpoint confiável para acionar a investigação. A documentação da AWS mostra que esse webhook pode usar HMAC, com timestamp e assinatura calculada sobre o payload. Para ambientes regulados, isso é preferível a fluxos improvisados com automações sem validação de integridade.
3. Libere acesso de leitura ao cluster
No console do EKS, valide o modo de autenticação, crie a Access Entry com a role correta e aplique a policy indicada. Se o objetivo for limitar superfície de acesso, a própria configuração permite escopo por cluster ou por namespaces.
4. Implante o Operator e teste um caso simples
Antes de esperar um incidente real, force um cenário controlado e verifique se a investigação recebe manifesto, eventos e logs. A própria AWS sugere validar a integração fazendo perguntas simples ao agente sobre pods e eventos recentes do cluster.
Em quais falhas esse modelo entrega mais valor?
Ele tende a ser mais útil quando o tempo destrói evidência. O exemplo clássico é o pod que falha, reinicia e volta tão rápido que o time perde o estado anterior. A postagem técnica da AWS cita cenários como OOMKilled e exaustão de IP, ambos comuns em clusters com autoscaling, picos de carga ou configuração desigual entre workloads.
Também faz diferença em plantões fora do horário comercial. Quando a coleta inicial já chega estruturada, o operador começa a discussão em cima de hipótese e impacto, não em cima de comandos básicos. Para quem opera ambientes que não podem parar, isso pesa mais do que ter mais uma ferramenta bonita no console.
Há diferença entre EKS em EC2 e EKS em Fargate nessa investigação?
Sim, e essa diferença deve influenciar sua expectativa. Segundo a AWS, em Fargate o Operator continua coletando dados de nível Kubernetes, como manifesto, eventos e logs de containers. O que não existe é acesso a sinais de nó, como dmesg e introspecção do IPAMD.
Na prática, isso significa que aplicações stateless e problemas claramente delimitados ao pod ainda podem ser analisados com boa qualidade em Fargate. Já incidentes com dependência forte de kernel, runtime do host ou rede do worker ficam melhor instrumentados em grupos de nós EC2 bem governados.
Erros que aumentam o MTTR mesmo com o agente configurado
- Usar a role errada na Access Entry e assumir que o agente já enxerga o cluster.
- Criar o webhook, mas não validar assinatura, timestamp e payload em testes controlados.
- Esperar diagnóstico de nó em Fargate, onde esse nível de sinal não está disponível.
- Conectar poucas fontes ao Agent Space e depois cobrar análise contextual.
- Implantar o fluxo em produção sem simular ao menos uma falha conhecida.
Se o objetivo é ganhar velocidade real, o melhor uso desse stack não é apenas instalar componentes. É desenhar um caminho reproduzível de evidências, permissões mínimas e perguntas operacionais úteis. É exatamente aí que uma operação especializada, como a da Interserv Cloud, costuma encurtar o caminho entre prova de conceito e rotina confiável de incident response.
Perguntas frequentes
O AWS DevOps Agent funciona no EKS sem o Operator?
Não. O agente consegue investigar o cluster com comandos de leitura, mas o Operator é o componente que detecta a falha no momento em que ela acontece, coleta logs, eventos e manifesto do pod e dispara a investigação automaticamente. Sem ele, a análise tende a começar tarde, quando parte do contexto já sumiu.
Quais permissões são necessárias para investigar um cluster EKS?
Os pré-requisitos centrais são um Agent Space configurado, um webhook válido, acesso do agente ao cluster via EKS API e permissões de leitura adequadas. Se você quiser coleta em nível de nó em workers EC2, também precisa registrar os nós no Systems Manager com a policy apropriada.
O Operator ajuda mesmo quando o pod reinicia rápido?
Em muitos casos, sim. Quando um pod falha e é recriado rápido, parte do material mais útil para troubleshooting desaparece da visão imediata do operador. A proposta do Operator é capturar esse contexto cedo, antes de reinicializações, deleções ou mudança de estado dificultarem a análise.
Há diferença entre EKS em EC2 e EKS em Fargate nessa investigação?
Não totalmente. Segundo a AWS, em EKS sobre AWS Fargate o Operator coleta dados no nível Kubernetes, como manifesto, eventos e logs de containers, mas não consegue obter sinais de nível de nó, como dmesg e introspecção do IPAMD, porque esse tipo de acesso não está disponível nesse modelo.
Como validar se a configuração do agente no EKS está correta?
O erro mais comum é liberar acesso ao cluster de forma parcial ou com a role errada. Antes de depender do fluxo em produção, valide se o modo de autenticação do cluster inclui a EKS API, se a Access Entry aponta para o ARN correto do Agent Space e se o agente consegue responder perguntas simples sobre pods e eventos.