Se a sua pipeline instala automaticamente a versão mais nova de um pacote, você pode trazer um incidente para dentro do ambiente em minutos. Em npm e PyPI, isso é especialmente perigoso quando um pacote malicioso aparece, é promovido por typo ou compromete uma dependência transitiva. Para times que operam sistemas críticos, a defesa mais barata e eficaz costuma ser simples: criar uma janela de espera antes de aceitar novas versões.
Essa prática faz sentido para squads de desenvolvimento, segurança e plataforma que precisam manter velocidade sem abrir mão de controle. Na prática, o cooldown de dependência reduz a chance de consumir malware recém publicado, preserva previsibilidade no deploy e dá tempo para a comunidade, o registro e seu time reagirem.
Destaques que realmente mudam o risco
- O maior risco está no automático sem filtro: instalar
latestou ranges muito abertos acelera tanto entrega quanto exposição. - A janela de espera funciona como quarentena operacional: 24 a 72 horas já eliminam boa parte dos ataques relâmpago.
- npm e PyPI já tratam remoção e reversão com cautela: isso é ótimo para estabilidade do ecossistema, mas significa que sua proteção não pode depender só do registro.
- Cooldown não substitui governança: ele precisa andar com lockfile, revisão de pacote crítico, alertas e política de exceção.
- Ambientes críticos precisam de regra por criticidade: a mesma política não serve para uma lib auxiliar e para um pacote de autenticação.
O cooldown de dependência reduz a superfície de ataque logo no ponto de entrada
O conceito é direto: sua pipeline só aceita uma nova versão depois que ela envelhece um período mínimo. Em vez de instalar um release publicado há 5 minutos, você exige que ele tenha, por exemplo, 48 horas. Esse atraso controlado não elimina risco, mas reduz muito a exposição ao momento mais caótico de um release comprometido.
Isso importa porque muitos ataques à supply chain dependem de velocidade. O invasor publica, conta com pipelines automáticas e tenta atingir o maior número possível de ambientes antes de denúncia, yank, depreciação ou investigação. Quando a empresa cria uma quarentena curta, o tempo deixa de favorecer o atacante.
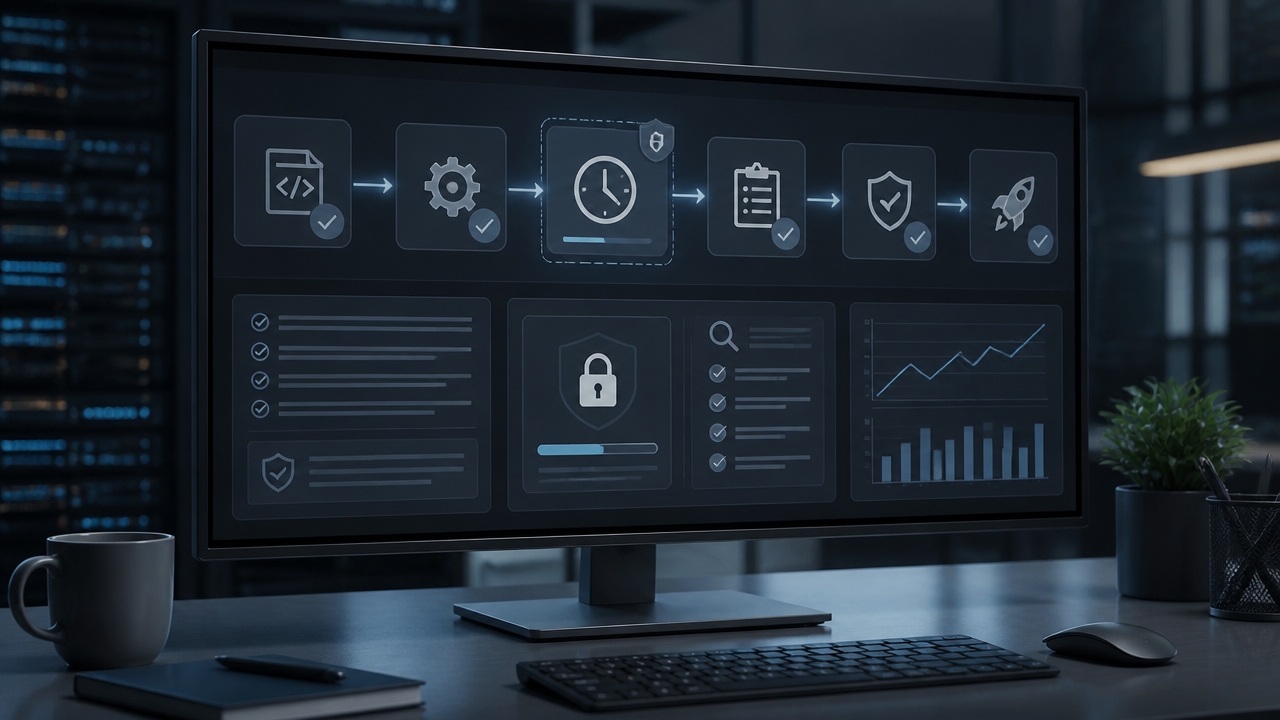
Na Interserv Cloud, esse tipo de política costuma gerar resultado rápido porque atua onde o incidente nasce: na decisão de instalar. Em vez de depender apenas de varredura posterior, o time impede que a versão entre cedo demais no fluxo de build e deploy.
Por que npm e PyPI exigem esse cuidado extra?
Porque os dois ecossistemas foram desenhados para escala e automação. A documentação do npm deixa claro que nome e versão formam um identificador único do pacote, e a especificação do Python Packaging Authority trata versões e restrições como metadados centrais para ferramentas automatizadas. Em termos práticos, isso significa que pipelines, instaladores e bots tomam decisões com base nesses metadados o tempo todo.
Quando essa automação encontra ranges permissivos, dependências transitivas e publicação rápida, abre-se espaço para ataques como typosquatting, account takeover, protestware e pacotes que mudam de comportamento de uma versão para outra. O problema não é só o pacote popular. Muitas vezes, o caminho do incidente passa por uma biblioteca pequena que entrou indiretamente.
Outro ponto importante é o modelo de remoção. Segundo a política de unpublish do npm, pacotes novos podem ser removidos em até 72 horas em condições específicas, e versões usadas não podem simplesmente ser reutilizadas depois. No PyPI, a função de yanking retira um release da seleção normal do instalador, mas não apaga a realidade de que ele já pode ter sido baixado. Por isso, esperar um pouco antes de adotar uma versão nova costuma ser mais seguro do que tentar remediar depois.
Qual janela de espera adotar em cada cenário?
A melhor resposta é baseada em criticidade, não em moda. Para a maioria dos times, 24 horas já melhora o cenário. Para sistemas sensíveis, 48 ou 72 horas criam uma barreira mais robusta sem travar a engenharia.
| Cenário | Janela sugerida | Observação |
|---|---|---|
| Dependências de baixo impacto | 24 horas | Boa opção para bibliotecas internas de apoio e utilitários simples |
| Dependências comuns de aplicação | 48 horas | Equilíbrio entre velocidade e redução de risco |
| Pacotes críticos de auth, crypto e runtime | 72 horas | Pedir revisão adicional e aprovação explícita |
| Dependências novas ou pouco conhecidas | 72 horas ou mais | Combinar com validação manual e análise de reputação |
Se o seu negócio depende de alta disponibilidade, vale separar dependências por classe. Framework principal, SDK de pagamento, bibliotecas de autenticação e agentes de observabilidade merecem tratamento mais rígido do que pacotes de desenvolvimento local.
Como aplicar a política sem travar o time
O segredo é automatizar a regra e formalizar exceções. O cooldown não deve virar uma conversa manual a cada release. Ele precisa existir como política de pipeline, com critérios objetivos para liberar ou bloquear.
Quais controles precisam acompanhar a janela de espera?
- Fixar versões com lockfile e revisar mudanças no arquivo de lock.
- Evitar ranges abertos demais em dependências sensíveis.
- Criar allowlist para fornecedores e pacotes críticos.
- Separar update automático de update para produção.
- Exigir aprovação para primeira adoção de pacote novo.
- Monitorar yanks, depreciações e alertas de vulnerabilidade.
Também ajuda dividir o processo em dois fluxos. Um fluxo padrão atualiza dependências maduras após a janela mínima. Outro fluxo trata exceções urgentes, como patch de segurança necessário, mediante validação acelerada. Isso mantém agilidade sem voltar ao risco original.
O cooldown atrasa correções importantes?
Sim, um pouco, mas menos do que um incidente atrasa sua operação. O erro mais comum é tratar toda atualização como urgente. Na prática, poucas versões precisam entrar em produção no minuto em que saem.
Uma política madura diferencia urgência real de impulso de atualização. Se surgir um patch crítico confiável, o time pode usar uma exceção documentada, com testes, aprovação e rollback planejado. O importante é que a exceção seja rara e auditável, não o padrão silencioso da pipeline.
Para organizações reguladas, essa abordagem ainda melhora rastreabilidade. Você sabe por que uma versão foi liberada antes do prazo, quem aprovou e qual risco residual foi aceito. Isso é muito mais defensável em auditoria do que um histórico de builds puxando a novidade mais recente sem contexto.
Uma política mínima para começar ainda esta semana
Se sua empresa ainda não tem governança de dependências, comece pequeno e consistente. Melhor uma regra simples aplicada em todos os repositórios do que uma arquitetura ideal que nunca sai do papel.
- Defina 48 horas como padrão para npm e PyPI.
- Marque pacotes críticos que exigem 72 horas e aprovação.
- Bloqueie instalação automática de dependências inéditas em produção.
- Revise lockfiles em pull requests.
- Registre exceções com motivo, responsável e prazo.
- Monitore incidentes, yanks e depreciações semanalmente.
Esse conjunto já reduz risco com baixo esforço. A partir daí, dá para evoluir para score de fornecedor, políticas por criticidade e integração com monitoramento contínuo. É exatamente nesse tipo de jornada que a Interserv Cloud ajuda: transformar boas práticas soltas em controle operacional, com segurança, escalabilidade e previsibilidade de custo.
Perguntas frequentes
O que é cooldown de dependência?
É uma política que impede a instalação imediata de versões recém publicadas. A pipeline espera um período, como 24, 48 ou 72 horas, antes de aceitar a atualização. Esse intervalo reduz a chance de consumir um pacote malicioso publicado há poucos minutos, antes da comunidade ou do registro reagirem.
Por que npm e PyPI são alvos frequentes de ataques?
Porque muitos ataques à supply chain exploram automação e velocidade. Se seu build sempre instala a versão mais nova, um pacote malicioso pode entrar no ambiente logo após a publicação. A janela de espera cria tempo para detecção, denúncia, yank, depreciação ou revisão interna antes do deploy.
O cooldown atrasa correções importantes?
Nem sempre. Em sistemas críticos, o ideal é combinar faixas de versão controladas, lockfile, aprovação manual para bibliotecas sensíveis e uma política de exceção. Atualizações urgentes continuam possíveis, mas saem do fluxo automático e passam por validação rápida antes da liberação.
Qual período de espera faz mais sentido?
Comece com 24 horas para dependências de baixo risco e 72 horas para pacotes muito usados, recentes ou sem histórico confiável. Ambientes regulados ou de alta disponibilidade costumam aplicar janelas maiores para dependências indiretas e componentes ligados a autenticação, criptografia e observabilidade.
Cooldown sozinho resolve o problema?
Não. Ele reduz a exposição a ataques relâmpago, mas não bloqueia sozinho typosquatting, account takeover, protestware ou dependências comprometidas há mais tempo. O controle funciona melhor junto com lockfile, allowlist, scans, revisão de mudanças e monitoramento contínuo da pipeline.