Fazer backup de vários bancos MySQL na nuvem de forma eficiente não é só agendar um dump por noite. O que realmente funciona é combinar consistência, automação, retenção inteligente e restauração testada. Se você opera mais de uma aplicação, ambientes críticos ou cargas com janelas curtas, o desenho certo evita lentidão, surpresa no custo e falsa sensação de segurança.
Em ambientes AWS, esse tema costuma aparecer quando a empresa cresce e passa a ter dezenas de bases, réplicas, integrações e requisitos de auditoria. Nessa hora, a Interserv Cloud ajuda a transformar backup em processo operacional confiável, com foco em segurança, escalabilidade e recuperação real.
Os pontos-chave para acertar a estratégia
- Defina RPO e RTO antes da ferramenta: sem isso, o backup vira rotina sem objetivo claro.
- Não trate todas as bases do mesmo jeito: bancos transacionais, analíticos e temporários pedem políticas diferentes.
- Combine camadas: full, incremental, binlogs e snapshots têm papéis distintos.
- Envie para object storage com retenção: guardar tudo no mesmo servidor não é plano de continuidade.
- Monitore falha e duração dos jobs: backup sem alerta é problema escondido.
- Teste restauração com frequência: o sucesso do backup só se prova no restore.
A eficiência começa ao separar bancos por criticidade e janela de recuperação
O maior erro em ambientes com muitos bancos MySQL é aplicar uma única rotina para todos. Isso simplifica a agenda, mas piora custo, tempo de execução e recuperação. O caminho mais eficiente é classificar as bases por criticidade, tamanho, frequência de mudança e impacto de indisponibilidade.
Uma base financeira, por exemplo, costuma pedir RPO mais agressivo do que uma base de cache operacional. Já um banco com poucas alterações diárias pode ter backup completo menos frequente, desde que a retenção e a restauração estejam bem definidas. Esse recorte reduz processamento desnecessário e ajuda a priorizar o que realmente sustenta a operação.
Na prática, vale montar ao menos três grupos:
- Críticas: alta frequência de alteração, RPO curto, retenção forte e restore validado.
- Importantes: backups regulares, retenção intermediária e testes por amostragem.
- Secundárias: menor frequência, retenção enxuta e foco em custo.
Esse desenho evita desperdiçar recursos com bases pouco relevantes e melhora a proteção onde a empresa não pode falhar.
Qual a melhor estratégia para criar backups?
A melhor estratégia mistura métodos. Em MySQL, raramente um único mecanismo atende velocidade, consistência e recuperação granular ao mesmo tempo. O ideal é combinar backup lógico ou físico com captura contínua de binlogs e armazenamento externo.
Para bases pequenas ou médias, dumps lógicos ainda funcionam bem quando há organização por banco, compressão e paralelismo controlado. Para volumes maiores e janelas curtas, backups físicos ou snapshots consistentes tendem a ser mais rápidos. Já os binlogs entram para recuperar mudanças entre um backup completo e outro.
| Método | Quando faz sentido | Vantagem principal | Atenção |
|---|---|---|---|
| Dump lógico | Bases menores, restore seletivo | Portabilidade | Pode demorar em volumes altos |
| Backup físico | Grandes volumes e janela curta | Rapidez | Exige processo mais cuidadoso |
| Binlogs | Ambientes com RPO curto | Recuperação ponto no tempo | Precisa retenção e organização |
| Snapshot | Infra em cloud com automação | Simplicidade operacional | Não substitui validação de restore |
Quando a rotina é bem desenhada, cada camada cobre uma falha diferente. Isso é mais eficiente do que apostar tudo em um único job noturno.
Como fazer backup de banco de dados MySQL?
Para vários bancos MySQL, o processo mais seguro é padronizar a execução por etapas. A conclusão é simples: menos improviso, mais previsibilidade. A rotina precisa garantir consistência, nomeação clara, criptografia, retenção e envio automático para um destino separado.
- Inventarie todas as bases e classifique por criticidade.
- Defina a política de cada grupo, incluindo full, incremental e retenção.
- Execute os backups com janelas distribuídas, evitando concentração no mesmo horário.
- Comprima e criptografe os arquivos antes do envio.
- Armazene em bucket com controle de acesso mínimo e versionamento.
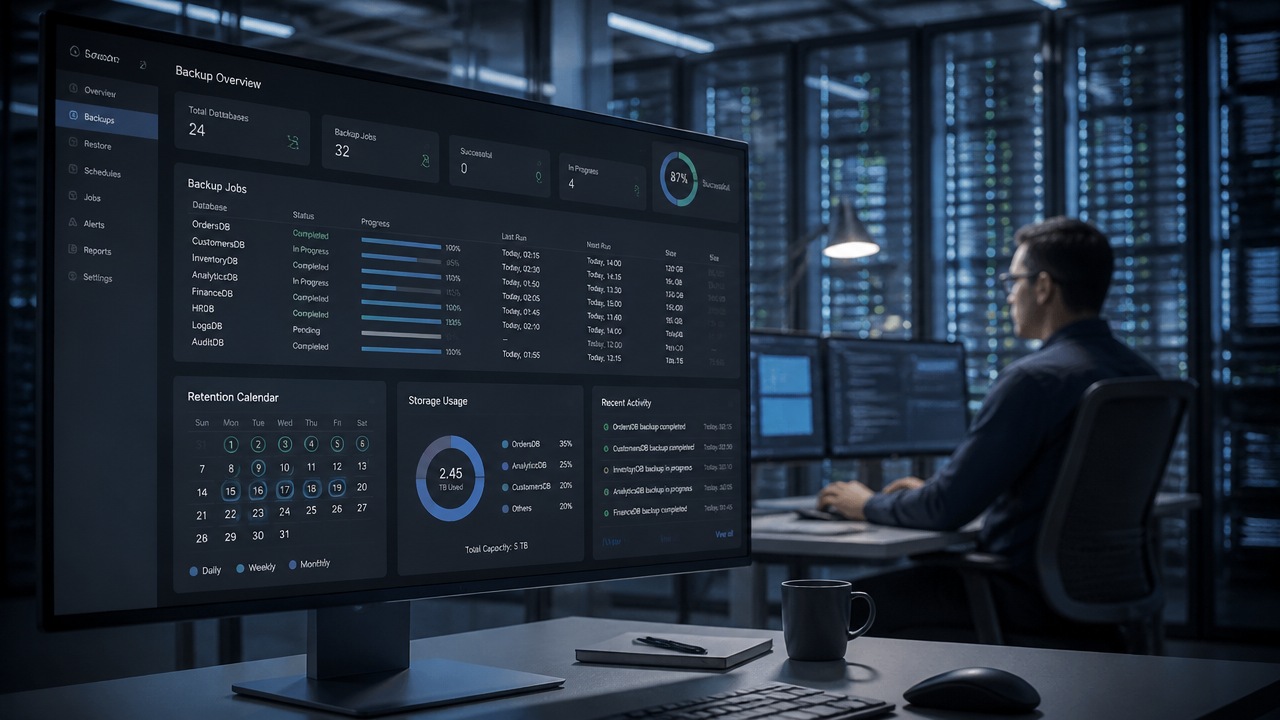
- Registre logs, duração, tamanho e status de cada job.
- Teste restauração parcial e completa em agenda fixa.
O ponto decisivo é evitar scripts frágeis demais. Quando há dezenas de bases, pequenas falhas de credencial, espaço temporário ou timeout passam despercebidas. Na Interserv Cloud, esse tipo de operação costuma ser tratado como pipeline operacional, com observabilidade e resposta 24/7, não como tarefa isolada de administração.
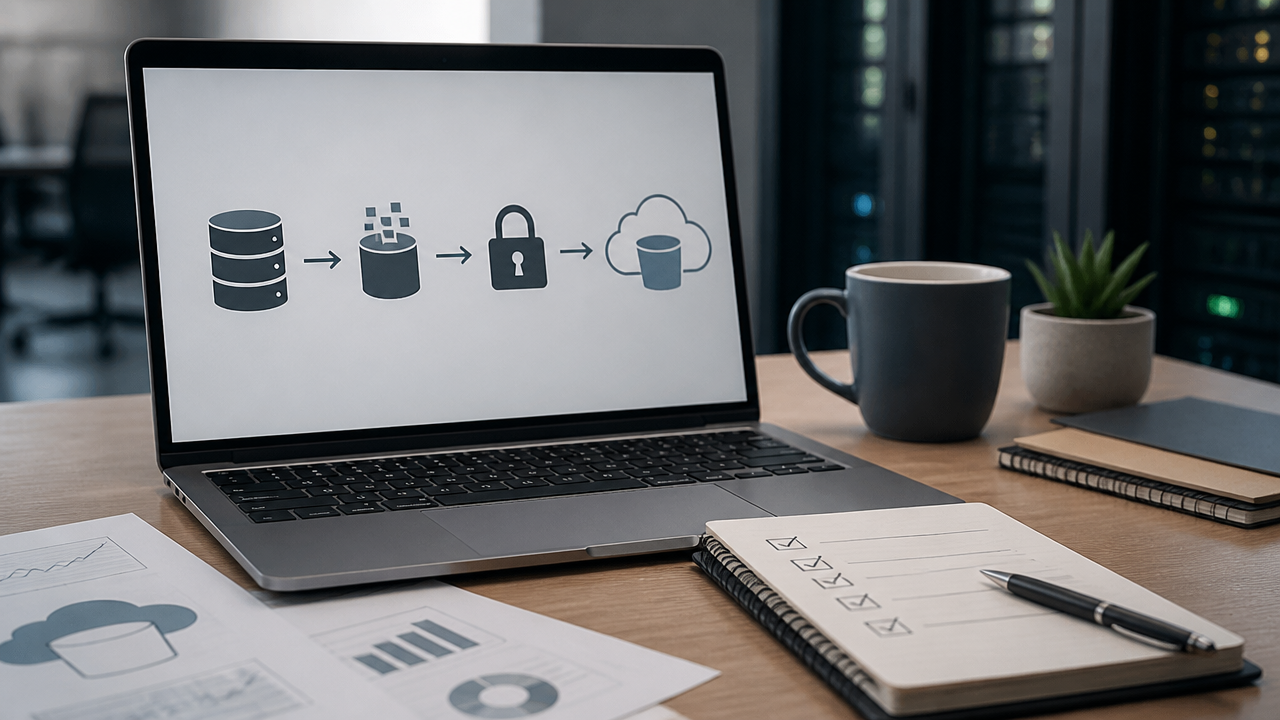
Como fazer backups na nuvem sem elevar demais o custo
Backup eficiente não é o mais barato por arquivo, e sim o que entrega recuperação confiável com custo previsível. Em cloud, o gasto cresce quando a empresa mantém cópias redundantes sem política, transfere arquivos desnecessários e retém tudo na camada mais cara.
O melhor desenho costuma usar object storage como destino principal, com regras de ciclo de vida e retenção por camadas. Bases críticas podem ficar acessíveis por mais tempo em uma classe com recuperação rápida. Cópias antigas, usadas só para auditoria ou contingência, podem migrar para classes mais econômicas.
Para reduzir desperdício, aplique estas práticas:
- Compactar antes do envio.
- Eliminar bases temporárias da rotina padrão.
- Separar retenção operacional de retenção regulatória.
- Apagar artefatos locais após validação do upload.
- Evitar refazer backup completo quando binlogs resolvem o intervalo.
Também vale separar a conta ou ao menos o domínio administrativo onde os backups ficam armazenados. Isso melhora segurança e reduz o risco de um incidente no ambiente principal comprometer as cópias.
Quais são os 3 tipos de backup e como aplicar em MySQL?
Os três tipos clássicos são full, incremental e differential. Em MySQL, a aplicação prática depende da ferramenta e da arquitetura, mas a lógica permanece a mesma: equilibrar tempo de execução, espaço consumido e velocidade de recuperação.
O full captura uma cópia completa e serve como base para as demais. O incremental grava apenas o que mudou desde o último backup. O differential registra o que mudou desde o último full. Em muitos ambientes MySQL na nuvem, a combinação mais comum é full periódico com binlogs contínuos, porque entrega recuperação detalhada sem repetir volume desnecessário.
O importante é não escolher só pela velocidade do backup. Um método pode gravar rápido, mas complicar demais o restore. Em produção, a melhor pergunta não é “qual job termina antes?”, e sim “qual desenho recoloca a aplicação no ar com segurança dentro da janela esperada?”.
O método 3-2-1 continua atual para bancos na nuvem
Sim, e talvez esteja ainda mais relevante. Ter tudo em cloud não elimina o risco de erro humano, credencial comprometida, exclusão acidental ou ransomware. A regra 3-2-1 continua útil porque força diversidade de cópias e de contexto operacional.
Para bancos MySQL, uma leitura prática dessa regra pode ser:
- 1 cópia de produção ativa.
- 1 cópia de backup operacional no ambiente de storage definido para rotina.
- 1 cópia adicional fora do contexto principal, preferencialmente com retenção imutável.
As duas “mídias” podem aparecer como combinações de disco local temporário, snapshot e object storage. O mais importante é que uma falha administrativa ou um ataque não alcance tudo ao mesmo tempo. Em empresas sujeitas a auditoria, essa separação também ajuda a demonstrar governança.
Monitoramento e teste de restauração são o que separa backup real de checklist
Se o time só verifica se o arquivo existe, a operação ainda está incompleta. Backup eficiente exige monitoramento do processo inteiro, do início do job até a restauração em ambiente controlado. O indicador mais importante não é apenas sucesso de execução, e sim capacidade real de recuperar.
Monitore pelo menos estes sinais:
- Tempo total de execução por banco.
- Tamanho gerado e variações fora do padrão.
- Falhas de autenticação e permissões.
- Erros de consistência e corrupção.
- Status do upload para o bucket.
- Resultado dos testes de restore.
Quando esse fluxo entra em observabilidade contínua, a empresa sai do modo reativo. Para operações críticas, essa é uma frente natural de atuação da Interserv Cloud, principalmente quando o backup precisa conversar com segurança, escalabilidade, orçamento e resposta a incidentes.
Perguntas frequentes
Como fazer backup de banco de dados MySQL?
Para poucos bancos e bases pequenas, um dump lógico bem organizado costuma bastar. Quando há muitas bases, janelas curtas e volumes altos, a abordagem mais eficiente combina backup físico ou snapshots consistentes, retenção em object storage e testes frequentes de restauração.
Qual a melhor estratégia para criar backups?
A melhor estratégia é aquela que protege o dado e reduz o tempo de recuperação. Na prática, isso significa definir RPO e RTO, separar backups completos e incrementais, aplicar retenção por camadas, criptografar tudo e validar a restauração em ambiente controlado.
Como fazer backups na nuvem?
Backups na nuvem funcionam melhor quando saem de jobs automatizados, seguem para object storage com versionamento e ficam isolados do ambiente principal. O ideal é incluir criptografia, controle de acesso mínimo, políticas de ciclo de vida e monitoramento com alertas.
Quais são os 3 tipos de backup?
Os três tipos mais usados são full, incremental e differential. Em MySQL, eles podem aparecer como dumps completos, cópias físicas periódicas e captura contínua de binlogs. A combinação entre eles equilibra custo, tempo de backup e velocidade de recuperação.
O que é o método de backup 3-2-1?
A regra 3-2-1 recomenda manter 3 cópias dos dados, em 2 mídias ou locais diferentes, com 1 cópia fora do ambiente principal. Em nuvem, isso costuma significar produção, cópia operacional separada e uma cópia imutável ou em outra conta.